

404
Nuestros papás y abuelos leían enciclopedias, les tomaba aproximadamente de 5 a 10 minutos encontrar lo que estaban buscando, la mayoría de nosotros crecimos con Wikipedia, nos tomaba tres minutos encontrar lo que estábamos buscando. Hoy en día, prendes tu celular, escribes tres-cuatro palabras y en segundos tienes la información que no sabías que necesitabas.
La inteligencia artificial pasó de ser un tema de conferencias académicas a ser el motor que sostiene buena parte del crecimiento económico mundial. No es exageración: hoy hay analistas serios discutiendo si el PIB de Estados Unidos crecería si le quitáramos los centros de datos. Pero para entender cómo llegamos hasta acá, y por qué esto importa tanto, hay que retroceder bastante más de lo que uno imagina.
Todo empezó con una pregunta
En 1950, un matemático británico llamado Alan Turing publicó un artículo con una pregunta que sonaba futurista: ¿pueden pensar las máquinas? Turing era lo bastante astuto como para saber que esa pregunta no tenía respuesta, así que la cambió por otra más práctica: ¿puede una máquina imitar a un ser humano tan bien que no notemos la diferencia? Eso es lo que hoy conocemos como el Test de Turing, y es el punto de partida de toda esta historia.
Seis años después, en el verano de 1956, un grupo de investigadores se reunió en el Dartmouth College, en New Hampshire. Iban a pasar dos meses trabajando en la idea de que “cada aspecto del aprendizaje puede describirse con tanta precisión que una máquina puede simularlo”. Ahí, en esa reunión, John McCarthy acuñó el término inteligencia artificial. La idea era optimista al punto de la ingenuidad: pensaban que en una generación el problema estaría resuelto.
Spoiler: no lo estuvo.
Los inviernos (en plural)
Las siguientes tres décadas fueron una montaña rusa. Hubo programas que resolvían teoremas de geometría, que jugaban ajedrez decentemente, que mantenían conversaciones simuladas. Cada avance venía acompañado de titulares grandilocuentes y de promesas de financiamiento. Y cada vez que las promesas no se cumplían, el dinero se iba.
A esos periodos de desilusión se les llama “inviernos de la IA”. El primero llegó a mediados de los setenta, cuando gobiernos británicos y estadounidenses recortaron presupuestos tras reportes demoledores sobre lo poco que se había logrado. El segundo llegó a finales de los ochenta, cuando la moda de los “sistemas expertos” —programas que codificaban a mano el conocimiento de especialistas en reglas del tipo si esto, entonces aquello— chocó con un muro. Funcionaban bien en dominios muy acotados, pero eran carísimos de mantener y frágiles como cristal. Cambiabas una variable del mundo real y el sistema se caía.
El problema de fondo era conceptual. Durante décadas se intentó construir inteligencia escribiendo reglas explícitas. Pero resulta que la mayor parte de lo que sabemos los humanos no está en reglas. Nadie puede escribir la lista de instrucciones para reconocer la cara de su mamá, o para saber que una silla es una silla aunque nunca haya visto ese modelo. Ese conocimiento es intuitivo, estadístico, aprendido a base de ejemplos.
El giro estadístico
En 1997, la computadora Deep Blue de IBM le ganó una partida de ajedrez a Garri Kaspárov, el campeón mundial. Fue un momento simbólico enorme, aunque técnicamente Deep Blue no era muy “inteligente”: ganaba por fuerza bruta, evaluando millones de posiciones por segundo. Aun así, marcó un cambio de mentalidad. Si no podemos programar la inteligencia, tal vez podamos entrenarla.
Los años noventa y dos mil fueron los años del aprendizaje automático estadístico. Filtros de spam, motores de recomendación, reconocimiento de voz mediocre pero funcional. Nada glamoroso, mucho trabajo silencioso. Y mientras tanto, tres cosas crecían en paralelo sin que casi nadie conectara los puntos: internet estaba generando cantidades absurdas de datos, las tarjetas gráficas diseñadas para videojuegos resultaron ser máquinas ideales para hacer millones de operaciones matemáticas en paralelo, y un puñado de investigadores tercos seguía trabajando en redes neuronales, una idea que la mayoría de sus colegas consideraba muerta desde los ochenta.
En 2012 los tres hilos se juntaron. Un equipo de la Universidad de Toronto presentó una red neuronal llamada AlexNet en una competencia de reconocimiento de imágenes y arrasó con el resto por un margen escandaloso. Este suceso cambió todo. De pronto todo el campo se reorientó hacia el aprendizaje profundo, o deep learning.
Para dimensionar lo de AlexNet:
La competencia se llamaba ImageNet y era sencilla de explicar: un millón de fotos etiquetadas en mil categorías —perros, hongos, camiones de bomberos, mandolinas— y equipos de todo el mundo presentando programas que intentaban clasificarlas. Durante años el progreso había sido de esos que solo emocionan a quien está adentro: uno o dos puntos porcentuales de mejora anual, arañados con mucho ingenio manual. Los mejores sistemas se equivocaban una de cada cuatro veces.
AlexNet —obra de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton— bajó la tasa de error de aproximadamente 26% a 15% de un solo golpe. En un campo acostumbrado a avanzar de a un punto por año, eso no fue ganar: fue romper la escala.
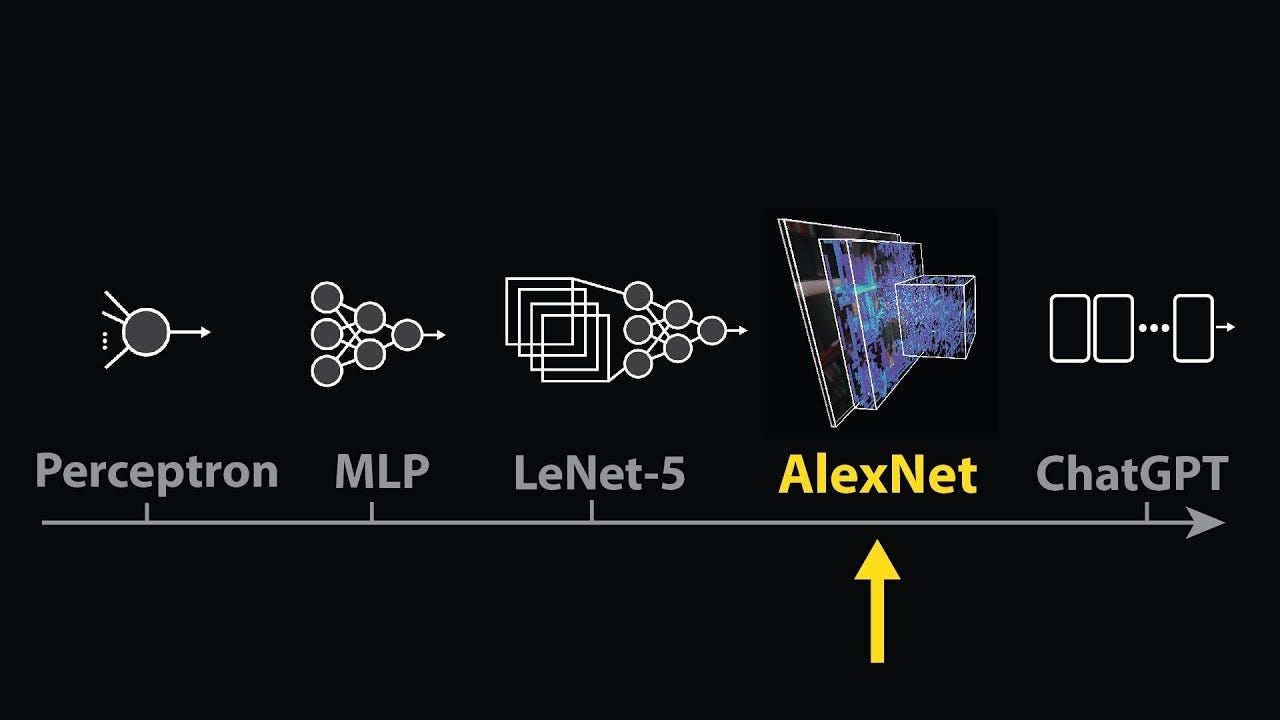
Y el detalle que más impresionó a quienes miraban de cerca fue cómo lo hicieron. No con una supercomputadora ni con un presupuesto militar, sino con dos tarjetas gráficas de consumo, del tipo que un adolescente compraba para jugar videojuegos, corriendo alrededor de una semana. El modelo no tenía escrita ni una sola regla sobre qué es un perro. Nadie le explicó qué son las orejas. Aprendió a reconocerlo mirando ejemplos, igual que un niño.
Los años siguientes fueron un desfile de hitos. En 2016, AlphaGo venció al campeón mundial de Go, un juego con más posiciones posibles que átomos en el universo observable y que se creía inmune a la fuerza bruta. La máquina hizo movimientos que los expertos humanos calificaron primero de errores y después de genialidades.
Hasta ese momento la idea dominante era que las computadoras eran herramientas obedientes y literales: rapidísimas y absolutamente tontas. Si querías que una máquina hiciera algo, tu trabajo era descomponerlo en instrucciones perfectas. AlexNet quebró esa intuición: había un sistema que hacía bien una tarea que nadie sabe explicar con palabras. Ningún programador puede escribir las reglas para distinguir un husky de un lobo, y ahí estaba la máquina distinguiéndolos. La percepción cambió de “las computadoras ejecutan” a “las computadoras pueden aprender”. La pregunta dejó de ser ¿qué sé programar? y pasó a ser ¿de qué tengo suficientes ejemplos? — infinitamente más ambiciosa, porque ejemplos hay de todo: radiografías, contratos, llamadas de servicio, código, conversaciones.
Y entonces llegó el dinero.
El efecto sobre la inversión fue casi inmediato. En 2013, meses después de ImageNet, Hinton y sus dos estudiantes crearon una empresa sin producto, sin clientes, sin ingresos: tres personas y un paper. Google la compró por unos 44 millones de dólares; no compraban una empresa, compraban a las únicas personas que sabían hacer eso. Al año siguiente pagó cientos de millones más por DeepMind, un laboratorio que tampoco vendía nada.
Eso disparó una guerra por talento con sueldos de deportista de élite y, más importante, cambió la naturaleza del gasto: la IA dejó de ser una línea del presupuesto de investigación (dinero que se quema con la esperanza de aprender algo) y se convirtió en gasto de capital estratégico. La investigación se recorta cuando vienen mal las cosas; la infraestructura estratégica se defiende. Por eso el dinero ya no se retiró como en los inviernos anteriores.
El otro gran beneficiado fue quien vendía las palas: Nvidia fabricaba chips para videojuegos y se descubrió dueña del insumo esencial de una industria entera. Reorientó todo su negocio y terminó siendo una de las empresas más valiosas del mundo. Todo esto pasó diez años antes de que la mayoría escuchara la palabra ChatGPT.
Si AlexNet convenció a ingenieros e inversionistas, AlphaGo convenció a todos los demás. El número de posiciones legales del Go supera la cantidad de átomos en el universo observable, así que la fuerza bruta de Deep Blue es inútil; se daba por hecho que faltaban décadas. AlphaGo le ganó 4-1 a Lee Sedol y casi doscientos millones de personas siguieron los partidos.
El momento que quedó fue la jugada 37 de la segunda partida: AlphaGo puso una piedra donde los comentaristas creyeron que era un error, casi una falla del programa. Setenta movimientos después, esa piedra era la clave de toda la partida — una idea original que dos mil quinientos años de tradición humana no habían encontrado. Ahí la percepción dio su segundo salto: las máquinas no solo aprenden lo que sabemos, encuentran cosas que no sabemos.
El paper que cambió todo
En 2017, un grupo de investigadores de Google publicó un artículo: Attention Is All You Need. Presentaba una arquitectura llamada Transformer que fue el equivalente al motor de combustión interna para esta industria.
La idea, muy simplificada, es que en lugar de procesar el texto palabra por palabra en orden, el modelo puede mirar todas las palabras a la vez y decidir cuáles son relevantes para entender cada una. Eso lo hace muchísimo más eficiente de entrenar, y sobre todo lo hace escalable: si le pones más datos y más cómputo, mejora. Y sigue mejorando. Y sigue.
Esa propiedad —que las cosas mejoran predeciblemente al aumentar la escala— fue lo que abrió las compuertas del dinero. Porque si sabes que invertir más produce mejores resultados, ya no estás haciendo investigación básica con resultados inciertos: estás haciendo una inversión de capital. Y ahí es donde la historia deja de ser una historia de ciencia y se convierte en una historia económica.
Noviembre de 2022
El 30 de noviembre de 2022, OpenAI lanzó ChatGPT. No era la tecnología más avanzada que existía en ese momento; era simplemente la primera vez que se le puso una interfaz sencilla a un modelo de lenguaje grande y se le entregó al público general. Llegó a cien millones de usuarios en dos meses. Ningún producto de consumo en la historia había crecido así.
Lo que siguió fue una de las carreras industriales más aceleradas que se recuerden. Google, Meta, Microsoft, Anthropic, Amazon, y del otro lado del mundo Baidu, Alibaba y DeepSeek. Modelos que dejaron de ser solo texto para procesar imágenes, audio y video. Modelos que aprendieron a “razonar” generando cadenas internas de pensamiento antes de responder, revisando sus propios errores.
Y ahora, en 2026, el tema del momento ya no son los chatbots sino los agentes: sistemas que no solo responden, sino que planifican una secuencia de pasos, usan herramientas, ejecutan tareas y entregan un resultado. Gartner proyecta que para finales de este año alrededor del 40% de las aplicaciones empresariales integrarán agentes especializados, comparado con menos del 5% hace poco. El cambio de “hazme un borrador” a “encárgate de esto” es la frontera actual.
Por qué la economía global se está reorganizando alrededor de esto
Acá viene la parte que explica por qué esto no es solo otra moda tecnológica.
Los números de infraestructura son difíciles de procesar. La inversión global en semiconductores, centros de datos e infraestructura de IA alcanzó unos 400 mil millones de dólares en 2025, y las proyecciones para 2026 rondan los 500 a 530 mil millones según análisis de Goldman Sachs y otros. La inversión total en tecnologías de la información creció cerca de 14% en 2025, superando los 4 billones de dólares: un ritmo que no se veía desde 1996, en plena euforia de internet.
Pero el dato que realmente vuelve la cabeza es otro: se estima que la inversión relacionada con IA representó cerca del 90% del incremento del PIB de Estados Unidos durante el primer semestre de 2025. Léelo otra vez. Una sola categoría de gasto sosteniendo casi todo el crecimiento de la economía más grande del mundo.
Hacia adelante, el FMI y consultoras como McKinsey proyectan que la IA podría añadir entre 0.4 y 3.5 puntos porcentuales anuales al crecimiento del PIB global en la próxima década. PwC estima una contribución superior a los 15 billones de dólares a la economía mundial para 2030. Son rangos amplísimos, lo cual es honesto: nadie sabe realmente.
Lo que sí es visible es cómo se reorganizan las piezas. Los chips avanzados se volvieron un asunto de seguridad nacional, con controles de exportación y tensiones geopolíticas alrededor de Taiwán y los Países Bajos. La electricidad se volvió un cuello de botella real, al punto de que hay empresas tecnológicas comprando plantas nucleares. Y hay una reconfiguración del mapa: Norteamérica concentra alrededor de un tercio del mercado, Asia-Pacífico crece a toda velocidad, y regiones enteras corren el riesgo de quedarse mirando desde afuera.
Lo que todavía no sabemos
Sería deshonesto terminar sin la otra cara. Hay tres preguntas grandes sin respuesta.
¿Es una burbuja? Cada vez más de esta inversión se financia con deuda, lo que hace al sector más frágil. Varios analistas no descartan una corrección bursátil. La comparación con 1999 se hace sola: y conviene recordar que internet efectivamente cambió el mundo y la burbuja punto-com efectivamente reventó. Ambas cosas pueden ser ciertas.
¿Y el empleo? Las cifras concretas todavía son modestas —unos 48 mil despidos atribuidos directamente a la IA en Estados Unidos hasta octubre de 2025— pero la tendencia inquieta, sobre todo en puestos de entrada. El desempleo juvenil es uno de los indicadores a vigilar.
¿Quién se lleva los beneficios? Se habla de una “economía en K”: algunos sectores y países disparándose hacia arriba mientras otros se estancan. La IA amplifica ventajas existentes, y eso no se corrige solo.
Entonces, ¿qué hacemos con esto?
Setenta años de trabajo acumulado, tres inviernos, un paper de 2017 y una interfaz de chat nos trajeron hasta acá. Lo que viene depende bastante menos de los modelos y bastante más de qué decidimos hacer con ellos: cómo los regulamos, cómo distribuimos lo que producen, y si logramos que la conversación la tengan más personas que un puñado de empresas en dos o tres países.
Vale la pena entenderla. No alabarla pero tampoco odiarla.